学習スコアの周回データを初見ベースラインに使わない
今回やったこと / この記事について
学習ツール導入後の成果を測るとき、過去の周回データを初見ベースラインに使わないという解釈ルールを固定した。対象は、自己テストや復習ログを蓄積している個人開発者である。テーマは点数の高低ではなく、その点数がどの条件で得られたものかを分けることだ。
きっかけは、学習ツール導入前にすでに3周済みだったセットの値を、導入後の初見性能として扱いかけたことだった。数字そのものは正しくても、測定条件を取り違えると結論が変わる。
SCSの85%と87%は初見値ではなかった
SCSではlap1が85%、lap2が87%だった。しかし、このセットは導入前に3周済みだった。したがって、これらは仕上がり後の復習値であり、学習ツールを使い始めた時点の初見1周目を表していない。
この数字を初見値として解釈すると、導入直後から高い理解があったように見える。実際には、事前学習の影響が含まれている。ユーザーから「ほぼ仕上がっている数値」と訂正を受けたことで、スコアの横に履歴と条件を記録する必要が明確になった。
| データ | 値 | 測定条件 | 初見比較に使えるか |
|---|---|---|---|
| SCS lap1 | 85% | 導入前に3周済み | 使わない |
| SCS lap2 | 87% | 既習セットの周回 | 使わない |
| UDM-MOCK1 lap1 | 44% | コールドオープン | 使う |
| UDM-MOCK1 正解数 | 34 / 78問 | 2026-07-07の初見記録 | 条件付きで使う |
比較対象として残すべき最初のコールドオープンは、UDM-MOCK1のlap1=44%だった。78問中34問正解で、記録日は2026-07-07である。この値も万能な基準ではないが、少なくとも「事前に何周したか」という条件を分離して扱える。
ベースラインを先に定義する
学習ログの比較では、次の3つを一つの表に置く必要がある。
- セットが導入前に何周されていたか
- 今回の測定が初見か、復習か
- 正答率と正答数が何問を分母にした値か
これを省いて正答率だけを並べると、仕上がったセットと初めて見るセットを同じ成長曲線に置いてしまう。数値が正しくても、比較対象が違えば「導入後に伸びた」「最初から分かっていた」といった誤った説明につながる。
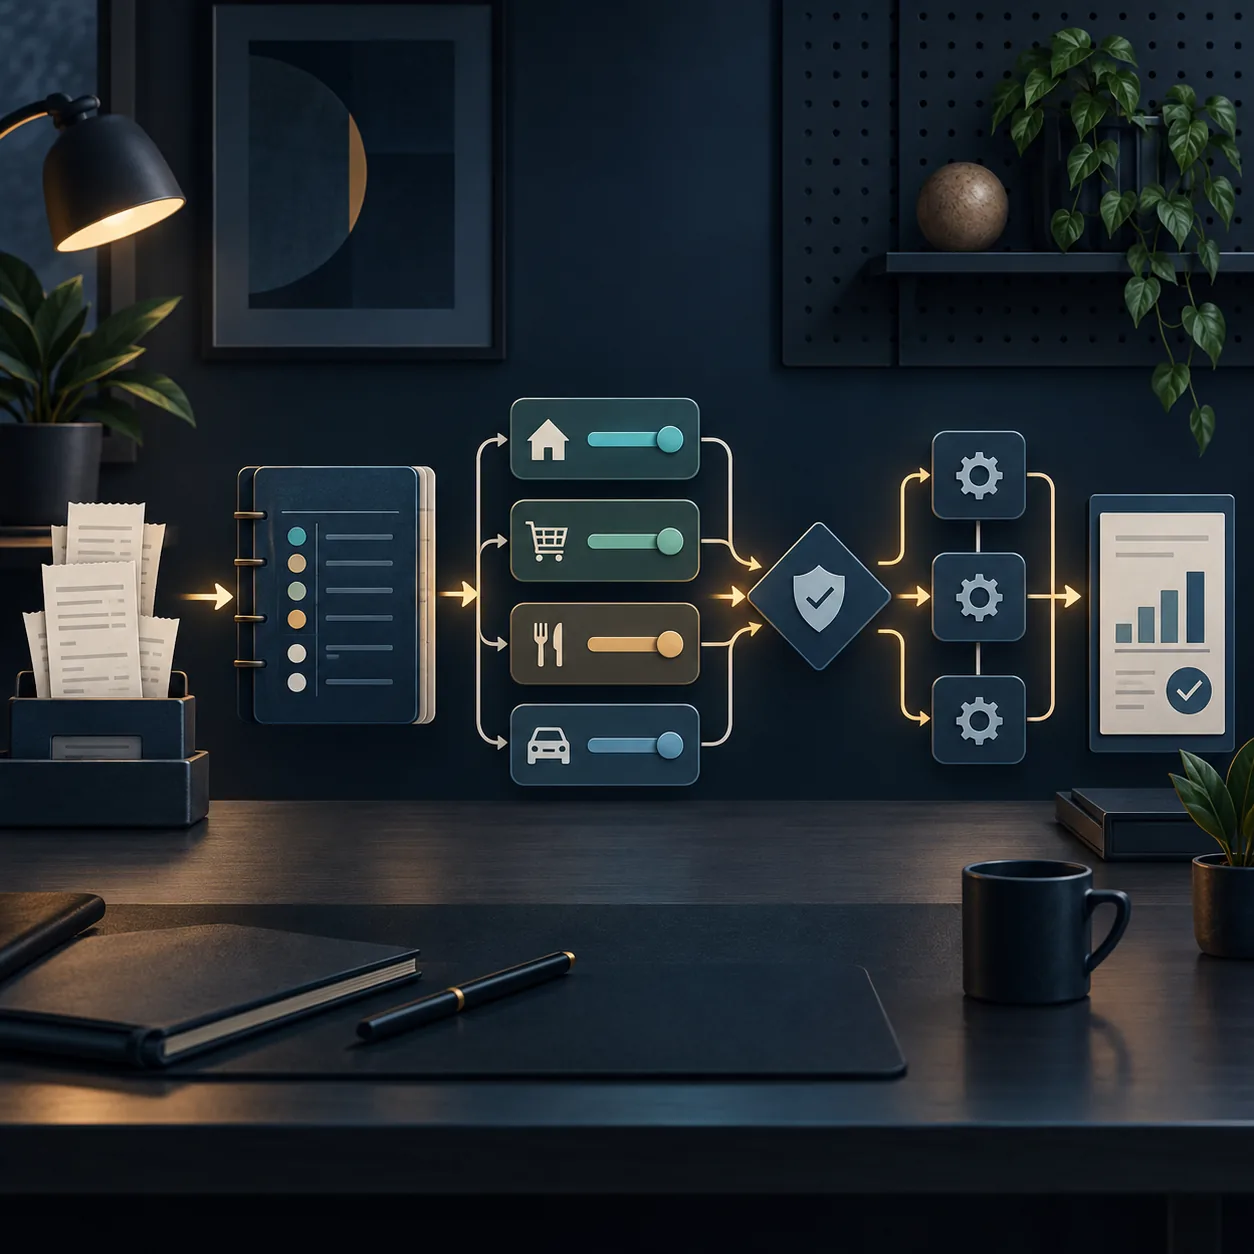
測定前
  ├─ 導入前の周回数を確認
  ├─ 初見 / 復習を分類
  └─ 問題数と記録日を固定
        ↓
       スコアを保存
        ↓
       同じ条件同士だけ比較
retire_reportのような周回推移を見るときも、事前学習済みセットと初見セットを分ける必要がある。周回回数が増えるほど点数が上がるのは自然だが、その上昇を導入効果と呼ぶには、導入前の履歴が必要になる。
数字を捨てずに、役割を変える
SCSの85%と87%を無効なデータとして削除する必要はない。これらは、仕上がったセットをどの程度維持できたかを見る復習データとして使える。問題は、初見ベースラインという別の役割を与えたことだった。
この切り分けにより、同じログから二つの見方を作れる。SCSは復習時の維持、UDM-MOCK1は初見時の出発点として扱う。値を増やすより、測定条件のラベルを失わないことが優先される。
やってみてわかったこと
学習ログで最初に固定すべきなのは、目標点ではなくベースラインの条件だった。初見と復習、導入前と導入後、周回済みとコールドオープンを分けるだけで、同じ数値の意味が変わる。
今後の記録では、スコアだけでなく、セットの履歴、lap番号、問題数、正答数、測定日を併記する。学習ツールの効果を評価するなら、結果の大きさを競う前に、比較可能な条件を作る必要がある。測定条件を先に固定することが、最も小さくて再現性のある改善だった。
更新履歴
- 2026-09-24: 初稿。SCSとUDM-MOCK1の条件差を整理。
訂正履歴
- なし。