完成した原稿を失わないために、起稿と出口を分ける
今回やったこと / この記事について
無人で記事を書く仕組みでは、本文が完成した時点を「成功」と呼びたくなる。しかし、原稿が利用できる状態になるまでには、その後に複数の工程が残る。今回の記録は、起稿エージェントが完成原稿を書いても、出口を通れず日々失われていた問題と、その役割分担を見直した経緯である。対象は、エージェントに記事生成からリポジトリへの登録までを任せている小規模な自動化レーンだ。
4つの出口は、別々に失敗する
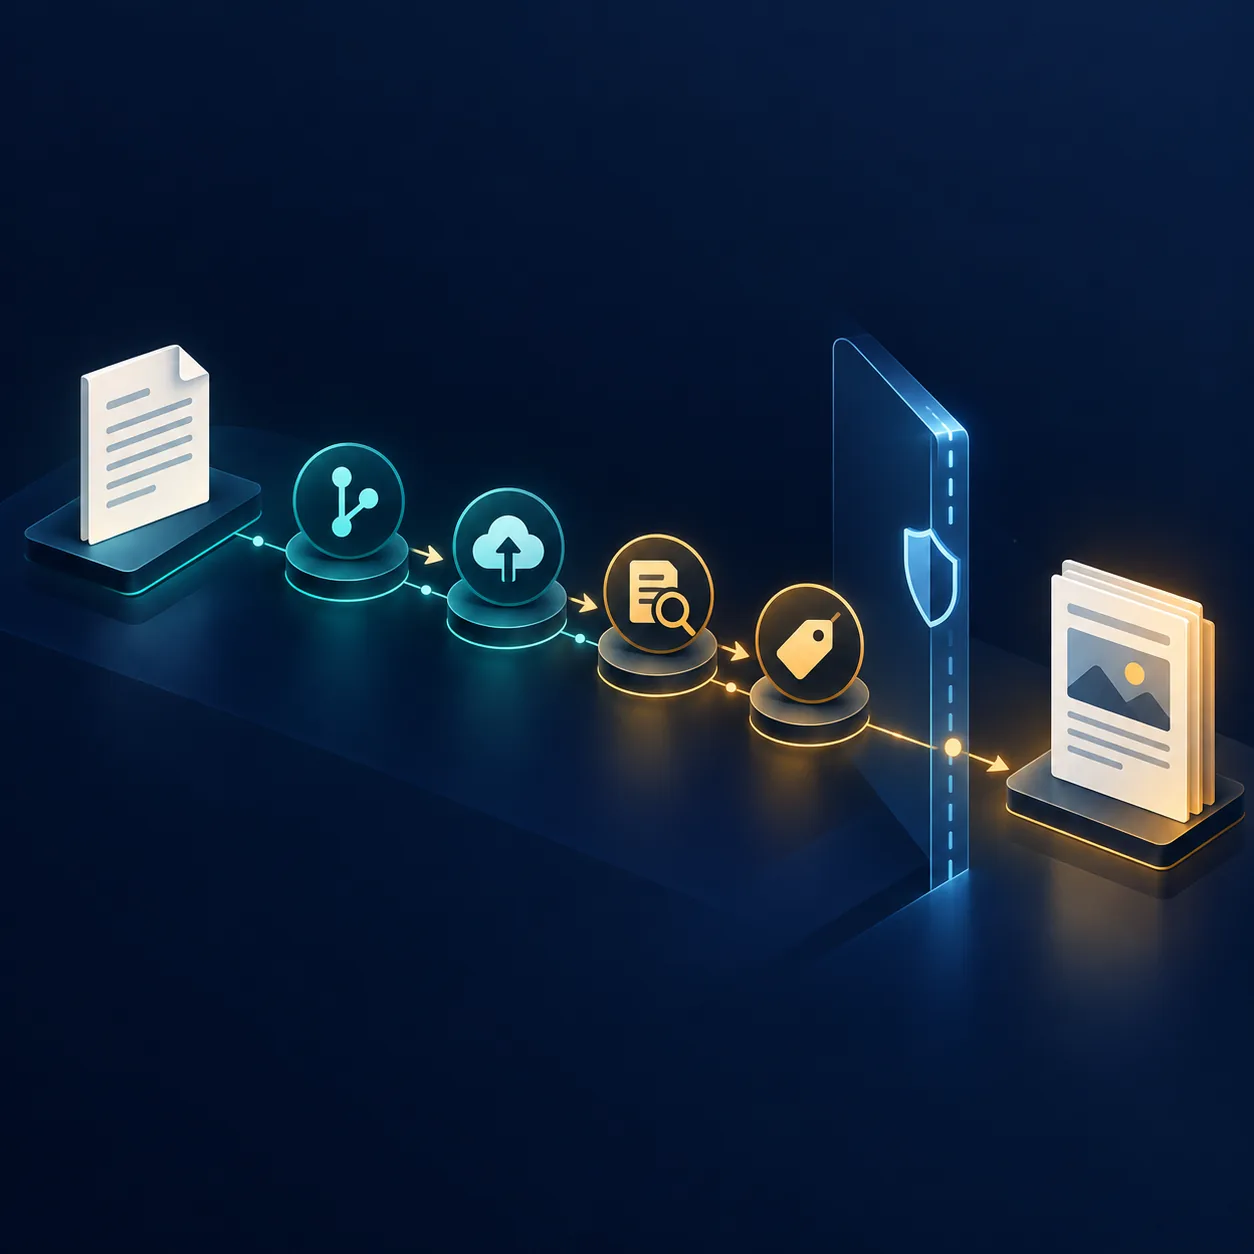
起稿後の出口は、commit、push、PRとラベル付与、draft PRを避けることの4工程に分かれていた。失敗の原因も同じではない。commitは実行環境のサンドボックスが .git を読み取り専用にするため止まる。pushは認証情報に書き込み権限がなく、読み取り専用に制限されているため止まることがある。PRができてもラベルが付かなければ、自動マージ側の条件と一致せず滞留する。さらに、GitHub上でdraftとして作ったPRは自動マージ処理に拾われない。
この区別が大切なのは、ひとつの工程が通ったことから残りも成功したと推測できないためだ。たとえばPR作成の成功は、必要なラベルが付いたことを意味しない。記事ファイルが存在することも、commitされたことを意味しない。出口を一つの「保存処理」として扱うと、どの段で止まったかがログから分からなくなる。
成功ログのまま、成果物が残らない
ある媒体では、18日間、毎朝作られた記事がリポジトリに残っていなかった。起稿側の記録はすべて exit=0 で、「成功」と報告されていた。完成した本文を作るところまでは動いていても、commit以降の工程は失敗していた。利用者から見ると記事が増えず、運用側の記録からは異常が見つからない状態だった。
ここで大きかったのは、commit失敗という単独の不具合より、成功報告が実際の成果物を示していなかったことだ。AIの応答が正常終了したか、記事ファイルができたか、後段の保存先に反映されたかは別の観測点である。成功の定義を最初の工程の終了に置くと、後段が止まっても定期実行の記録だけは正常に積み上がる。
書き手と実行機に役割を分ける
修正では、起稿AIの担当をファイル編集までに絞った。commit、push、PR作成、ラベル付与は、サンドボックスの外にある実行機側のランナーが担う。エージェントにgit操作を繰り返させて権限を変えようとするのではなく、権限と実行場所に合う側へ工程を移した形だ。
共通の出口処理は、検証、commit、push、PR、ラベル付与を呼び出し側から実行する構成になっている。また、成果物がゼロの場合と、変更があるのに記事として認識されない場合は区別される。後者は完成品を見落としている可能性があるため、単に「今日は書かなかった」と扱わない。
配線テストでは、各自動起稿レーンが共通出口の設定と整合しているかを確認する。パス許可やラベル条件が自動マージ側とずれると、原稿がPRになっても出口で滞留するためだ。テストは運用が成功したことの代わりではないが、レーンを追加した時に接続の抜けを見つける役割を持つ。
運用に持ち帰れる確認点
無人処理の「成功」は、AIが文章を返した時点だけで判定しない。少なくとも、ファイルが所定の場所に作られたか、検証を通ったか、実行機側の出口処理が動いたか、PRに必要な条件が付いたかを別々に観測する。出口を分けておけば、失敗時に再試行する工程も限定できる。
| 確認点 | 確認すること |
|---|---|
| 起稿 | 所定の原稿ファイルが存在する |
| 検証 | 対象ファイルを検査し、失敗を終了コードにも反映する |
| 保存 | commitとpushが完了する |
| 受け渡し | PRが作られ、後段が要求するラベルが付く |
この仕組みは、文章生成と配布処理を同じ権限の箱に押し込めないための設計である。エージェントにできる作業と、実行機にしかできない作業を分け、それぞれの完了条件をログと配線テストで確かめる。失敗の切り分けを細かくすることが、静かな取りこぼしを減らす。
更新履歴
- 2026-10-11: 初稿作成。